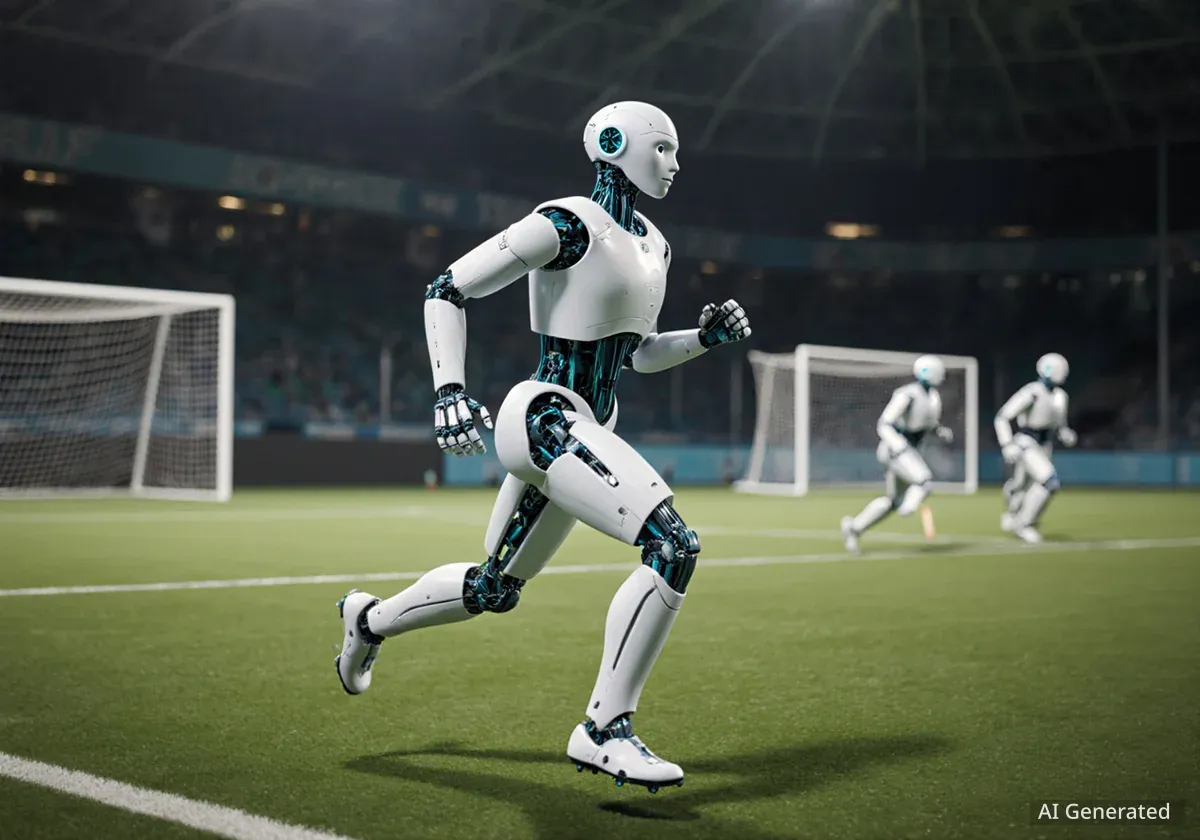
Die Forschung im Bereich der Robotik hat einen neuen Meilenstein erreicht: Das Unternehmen Skild AI trainiert sein Roboter-Grundlagenmodell S1 im Fußballspiel. Dabei tritt S1 in einer simulierten Umgebung über 140 Jahre lang gegen immer leistungsfähigere Versionen seiner selbst an. Ziel ist es, die Fähigkeiten des Roboters ohne menschliche Eingriffe zu verfeinern und komplexe Verhaltensweisen zu entwickeln.
Wichtige Erkenntnisse
- Skild AI's S1-Modell absolvierte über 140 Jahre simuliertes Selbstspiel in NVIDIA Isaac Sim.
- Der Roboter lernte zunächst grundlegende Fähigkeiten wie Dribbeln und Treten mit menschlicher Referenz.
- Im Selbstspiel entwickelte S1 komplexe Taktiken wie Ballabschirmung und Tackling nur durch die Zielsetzung des Toreschießens.
- Das trainierte Modell kann in der realen Welt gegen Menschen und andere Roboter spielen.
- Erste Anzeichen von Passspiel und Koordination zeigten sich in Spielen mit vier Agenten.
Revolutionäres Training durch Selbstspiel
Skild AI, ein führendes Unternehmen in der Robotik, hat einen neuartigen Ansatz für das Training seines S1-Grundlagenmodells vorgestellt. Das Modell lernt, Fußball zu spielen, indem es in einer virtuellen Umgebung gegen sich selbst antritt. Dieser Prozess, bekannt als Selbstspiel, ermöglicht es dem Roboter, seine Fähigkeiten kontinuierlich zu verbessern und komplexe Strategien zu entwickeln.
Das Training findet in der NVIDIA Isaac Sim-Umgebung statt, die eine realistische Simulation der physischen Welt bietet. Hier konnte S1 über 140 Jahre simulierte Spielerfahrung sammeln. Dabei spielte der Roboter gegen immer neuere, verbesserte Versionen seiner selbst. Diese Methode stellt sicher, dass die Herausforderung stets mit den wachsenden Fähigkeiten des Roboters Schritt hält.
„Diese Methode skaliert, und wir werden sie skalieren“, erklärte Deepak Pathak, Mitbegründer und CEO von Skild AI, in einem Beitrag auf X. Er verglich die Entstehung menschlicher Intelligenz mit Milliarden von Jahren physischen Selbstspiels und argumentierte, dass Roboter einen ähnlichen Weg einschlagen würden.
Die Phasen des Lernprozesses
Das Training von S1 gliedert sich in zwei Hauptphasen. Zunächst durchläuft der Roboter eine vorbereitende Phase, in der er grundlegende Fußballfertigkeiten erlernt. Dazu gehören Dribbeln in verschiedenen Geschwindigkeiten und Richtungen sowie das präzise Treten des Balls. Jede dieser Übungen ist mit einer spezifischen Belohnung und einer menschlichen Referenz verknüpft, die dem Roboter zeigt, wie die Aufgabe korrekt ausgeführt wird.
Faktencheck Robotik
- S1 gibt 50 Mal pro Sekunde Winkel für jedes humanoide Gelenk aus.
- Das Training nutzte NVIDIA Omniverse-Bibliotheken zur Erstellung des virtuellen Fußballfelds.
- Die 140 Jahre simulierte Erfahrung stellen akkumulierte Spielzeit dar, nicht die tatsächliche Trainingsdauer.
Nach dieser initialen Lernphase beginnt das eigentliche Selbstspiel. Hier hat der Roboter nur ein einziges Ziel: Tore schießen. Es gibt keine weiteren spezifischen Belohnungen für einzelne Verhaltensweisen wie Passspiel oder Tackling. Stattdessen lernt S1 durch die Erfahrung, was funktioniert und was nicht, um das Hauptziel zu erreichen. Diese Methode fördert die Entstehung komplexer, unvorhergesehener Strategien.
Fähigkeiten im realen Einsatz
Die beeindruckendste Erkenntnis aus diesem Experiment ist, dass das in der Simulation trainierte Modell in der Lage ist, in der realen Welt zu funktionieren. Skild AI berichtet, dass S1 gegen Menschen und andere Roboter auf einem physischen Fußballfeld spielen kann. Dies ist ein entscheidender Schritt für die Übertragbarkeit von KI-Modellen von der virtuellen in die physische Welt.
Die entwickelte Politik umfasst Fähigkeiten wie das Dribbeln an Verteidigern vorbei, das Abschirmen des Balls, das Tackling von Gegnern und sogar die Erholung nach Stürzen. Diese Verhaltensweisen entstehen nicht durch explizite Programmierung, sondern durch die kontinuierliche Optimierung im Selbstspiel.
Hintergrund: Skild AI und S1
Skild AI stellte sein S1-Grundlagenmodell im August vor. Damals zeigte das Unternehmen ein Modell, das unbekannte Manipulationsaufgaben aus einer einzigen Videoaufforderung ausführen konnte. Die aktuelle Forschung baut auf dieser Grundlage auf und verfeinert die bestehenden physischen Fähigkeiten durch wiederholten Wettbewerb.
Das Unternehmen meldete Anfang des Monats, dass es zehn Monate nach seiner ersten kommerziellen Einführung einen jährlichen wiederkehrenden Umsatz von über 100 Millionen US-Dollar erzielt hat. Dies unterstreicht die kommerzielle Relevanz der Forschung.
Emergente Verhaltensweisen und Teamwork
Ein besonders interessantes Ergebnis des Selbstspiels ist das Auftreten von Kooperation und Passspiel in Spielen mit vier Agenten. Obwohl das System nicht explizit auf Teamwork trainiert wurde, zeigte S1 in diesen komplexeren Szenarien Ansätze von sozialer Navigation und koordinierter Bewegung. Dies deutet auf das Potenzial hin, dass Roboter durch Selbstspiel auch kollaborative Aufgaben erlernen können.
Die Forschungsergebnisse legen nahe, dass dieser Ansatz auf andere Multi-Agenten-Aufgaben ausgeweitet werden könnte, bei denen ein klares Ziel definiert und ein Simulator aufgebaut werden kann. Dies könnte Anwendungen in Fabriken, auf Baustellen und in Haushalten ermöglichen, wo Roboter komplexe Interaktionen mit ihrer Umgebung und anderen Robotern meistern müssen.
Herausforderungen und Ausblick
Trotz der vielversprechenden Ergebnisse gibt es noch offene Fragen. Die genauen Details des Selbstspiel-Trainingsrezepts, der Rechenressourcen und der Anzahl der parallelen Matches wurden noch nicht vollständig veröffentlicht. Auch quantitative Bewertungen der Teamwork- oder sozialen Navigationsfähigkeiten stehen noch aus.
Ein weiterer wichtiger Punkt ist die Übertragbarkeit der in der Simulation erlernten Fähigkeiten auf kommerzielle Aufgaben. Es muss noch gezeigt werden, wie sich die Verbesserungen im simulierten Fußballspiel in eine bessere Leistung bei praktischen Anwendungen außerhalb des Spielfelds übersetzen lassen.
- Zukünftige Veröffentlichungen sollen Details zum Training, zur Übertragung von Simulation auf physische Humanoiden und zum sozialen Verhalten bei größeren Teamgrößen liefern.
- Google DeepMind hat bereits 2024 ähnliche Forschung betrieben, indem es Miniatur-Humanoiden durch Reinforcement Learning das Eins-gegen-Eins-Fußballspielen beibrachte.
Die Arbeit von Skild AI ist ein wichtiger Schritt in Richtung autonomer Roboter, die durch eigene Erfahrung komplexe Fähigkeiten erlernen können. Es bleibt abzuwarten, welche weiteren Fortschritte in den kommenden Jahren erzielt werden und wie diese Technologien unser tägliches Leben verändern werden.